TCC · visão computacional
LibrasFlow
Reconhece 21 letras do alfabeto manual de Libras pela webcam. O centro do TCC foi a avaliação: um 99,96% que escondia vazamento de dados virou 97,0% e, com imagens de outra fonte, 71,2%.
- Desenvolvimento principal (dados, treino, avaliação e aplicação web), em dupla
- 2026 · TCC de ADS, IFSP Jacareí
- em andamento
- Python · MediaPipe · OpenCV · scikit-learn · NumPy · pandas · SciPy · Flask
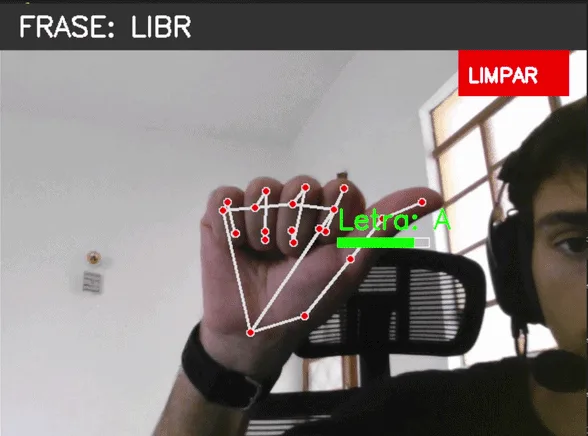
Resumo em 30 segundos
- Problema
- A primeira avaliação dava 99,96% de acurácia. Bom demais: 83,7% das amostras de teste tinham uma quase cópia no treino, vinda de quadros seguidos da mesma captura.
- Solução
- Agrupamos as amostras quase idênticas com DBSCAN (6.270 grupos) e dividimos treino e teste por grupo. Depois, testamos o modelo em 3.812 imagens de outra fonte.
- Resultado
- 97,0% no protocolo corrigido e 71,2% no teste externo, com a explicação de onde e por que o modelo erra, em vez do número mais bonito.
Contexto e problema
A comunicação entre pessoas surdas e ouvintes ainda esbarra em barreiras quando não há intérprete, e muitas soluções de reconhecimento exigem hardware forte ou a instalação de um programa. O LibrasFlow é o nosso TCC do curso de Análise e Desenvolvimento de Sistemas do IFSP Jacareí: um reconhecedor leve do alfabeto manual da Libras, que funciona com uma webcam comum, num computador modesto, pelo navegador.
O escopo são as 21 letras estáticas. H, J, K, X e Z envolvem movimento e ficaram de fora. O trabalho foi escrito como artigo científico, em preparação para submissão.
Minha função
O TCC foi feito em dupla com Carlos Henrique Moreira Gonçalves, com orientação do Prof. Dr. Tardelli Ronan Coelho Stekel e da Profa. Dra. Ana Paula Abrantes de Castro e Shiguemori. Fiquei com o desenvolvimento principal: a preparação dos dados, o treinamento, o protocolo de avaliação (incluindo a investigação do vazamento) e a aplicação web.
Solução e arquitetura
O modelo não olha a imagem bruta. O MediaPipe encontra 21 pontos da mão em cada quadro, e o classificador trabalha só com a geometria deles.
- CâmeraUm quadro da webcam
- MediaPipe Hands21 pontos da mão
- NormalizaçãoCentra no punho e ajusta a escala
- ClassificadorRandom Forest: dos 42 valores à letra
- Filtro de estabilidadeConfirma após 30 quadros iguais
- Letra na telaTexto em tempo real
- Atributos: as coordenadas x e y dos 21 pontos (42 valores), centradas no punho e divididas pelo maior valor absoluto. Isso reduz o efeito da posição e do tamanho da mão na imagem.
- Modelo: Random Forest com 100 árvores, profundidade máxima 15 e mínimo de 2 amostras por folha.
- Dados: o conjunto público "Libras" (Kaggle, Oliveira, 2022), com 34.374 amostras em 21 classes. Cada amostra é um vetor de pontos da mão, não uma foto.
- Confirmação temporal: uma letra só entra no texto depois de 30 quadros seguidos com a mesma previsão, o que reduz a oscilação entre letras parecidas.
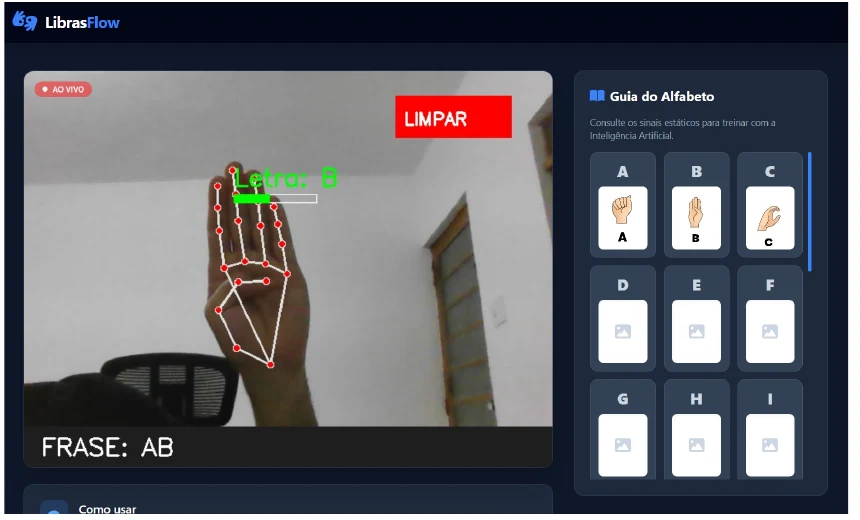
- Botão virtual "LIMPAR": acionado por gesto, quando a ponta do indicador fica 25 quadros sobre a área do botão.
Existem duas versões. Na do TCC, o Flask processa o vídeo no servidor e transmite o resultado para o navegador. Na versão pública, tudo acontece no próprio navegador: o MediaPipe roda em WebAssembly e a classificação usa uma rede MLP (63 → 128 → 64 → 21) exportada em JSON, com confirmação de 12 quadros e confiança mínima de 0,75. Nenhuma imagem sai do dispositivo.
O vazamento de dados
A primeira avaliação usou uma divisão aleatória 80/20, repetida 10 vezes, e deu 99,96% ± 0,02% de acurácia. Para um problema visual difícil, era bom demais, então fomos investigar.
Para cada amostra de teste, medimos a distância até a amostra mais próxima da mesma classe no treino. 83,7% tinham uma quase cópia a menos de 0,05 de distância: eram quadros consecutivos das mesmas capturas. Em parte, o modelo estava reconhecendo amostras que já tinha visto.
- 34.374 amostrasVetores com os pontos da mão
- DBSCAN (ε = 0,05)Junta as amostras quase idênticas
- 6.270 gruposMédia de 5,5 amostras por grupo
- Divisão por grupoCada grupo vai inteiro para o treino ou para o teste
Com a divisão por grupo, a fração de pares quase duplicados entre treino e teste caiu para 0%, e a distância típica entre os dois conjuntos aumentou cerca de 2,7 vezes. A acurácia ficou em 97,01% ± 2,59% (mínimo de 92,7%, máximo de 99,9%), com F1 macro de 96,7%.
- na primeira avaliação, com vazamento
- 99,96%
- com treino e teste divididos por grupo
- 97,0%
- em 3.812 imagens de outra fonte
- 71,2%
O resultado depende do raio ε do agrupamento, então fizemos uma análise de sensibilidade de 0,02 a 0,15. O valor 0,05 é o maior que mantém pelo menos 10 grupos por classe e os 20% de teste planejados.
| ε | Grupos | Acurácia |
|---|---|---|
| 0,02 | 30.266 | 99,97% |
| 0,05 (adotado) | 6.270 | 97,01% |
| 0,10 | 961 | 88,13% |
| 0,15 | 347 | 58,22% (partição instável) |
Teste com imagens de outra fonte
Um protocolo sem vazamento ainda testa com imagens do mesmo conjunto. Para medir a generalização, usamos o "Brazilian Sign Language Alphabet" (Passos; Fernandes; Comunello, 2020): 4.411 imagens de 15 letras, de outros autores e com outras condições de captura, incluindo iluminação pior. Esse conjunto não entrou no treino nem na escolha de hiperparâmetros.
O MediaPipe não encontrou a mão em 599 imagens (13,6%). Nas 3.812 restantes, a acurácia foi de 71,2% (IC 95%: 69,8%–72,6%), e a acurácia balanceada, de 58,9%.
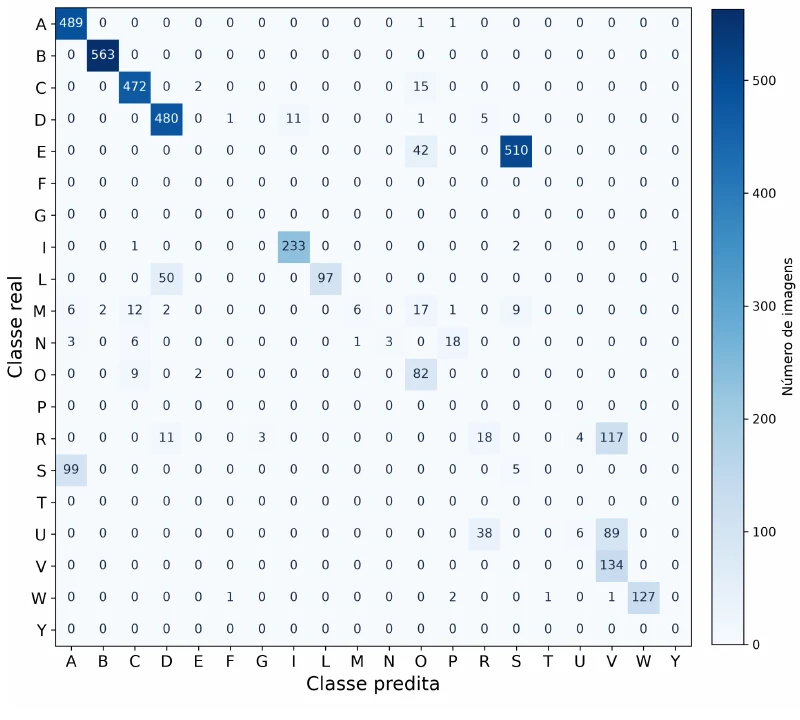
- M, N e E seguem outra língua de sinais. Nesse conjunto, essas letras aparecem na forma da língua de sinais americana (ASL), diferente da forma em Libras usada no treino. O E foi classificado como S em 510 de 552 imagens. Sem M e N, a acurácia vai a 72,6%; sem M, N e E, a 85,3% (IC 95%: 84,0%–86,4%).
- Os erros que sobram estão nos detalhes finos: pares que diferem por pouco, como S/A, R/V, U/V e L/D.
- A profundidade (z) não ajudou. Com 63 atributos, a acurácia interna não mudou de forma significativa (97,84%; teste de Wilcoxon, p = 0,85), e o teste externo piorou (69,4%; teste de McNemar, p < 0,001). Por isso o modelo adotado usa 42 atributos.
- A MLP da versão pública empata com o Random Forest no teste interno (96,4%), mas cai para 59,4% no externo. Ela é a demonstração funcional, não o modelo validado.
Desempenho em tempo real
Medido em 300 quadros, num notebook com i5-13420H, sem GPU dedicada, e webcam 720p:
| Etapa | Latência média |
|---|---|
| Detecção (MediaPipe) | 16,7 ms |
| Classificação (Random Forest) | 25,6 ms |
| Pipeline completo | 40,4 ms (≈ 24,8 FPS) |
Com a exibição na tela, a taxa observada de ponta a ponta foi de 19,5 FPS.
Experimente
A versão pública do projeto, embutida aqui. Ative a câmera, mostre uma das mãos e faça uma letra do alfabeto manual: o anel em volta da letra fecha quando o reconhecimento se firma.
Depois, clique em Ativar câmera
Roda no seu navegador: nenhuma imagem sai do seu computador.
A versão pública roda no navegador, com uma rede MLP; os números deste estudo são do Random Forest.
Stack
- Visão computacional: MediaPipe Hands e OpenCV.
- Modelo e avaliação: scikit-learn (Random Forest, MLP e DBSCAN), NumPy, pandas e SciPy.
- Aplicação do TCC: Flask, HTML5 e Tailwind CSS.
- Versão pública: MediaPipe Hand Landmarker em WebAssembly e a MLP exportada em JSON, tudo no navegador.
Decisões e trade-offs
Pontos da mão em vez da imagem
Com 42 números por quadro, o modelo é pequeno, roda em tempo real num computador sem GPU dedicada e depende menos do fundo e da iluminação.
Se o MediaPipe não detecta a mão, não há previsão. No teste externo, isso aconteceu em 13,6% das imagens.
Agrupar antes de dividir
Dividir por amostra mede memória. Dividir por grupo mede se o modelo reconhece uma pose que nunca viu.
O número fica menos bonito e passa a depender do raio do agrupamento; por isso a escolha do ε precisou de uma análise de sensibilidade.
42 atributos, sem a profundidade
A coordenada z não melhorou o teste interno e piorou o externo. Ficar com x e y deixa o modelo mais simples e com melhor resultado fora do conjunto de treino.
Pares que diferem por detalhes finos, como R/V e U/V, continuam sendo a maior fonte de erro.
Random Forest no estudo, MLP na demo
Na versão pública, a inferência acontece no navegador, com uma MLP exportada em JSON, e nenhuma imagem sai do dispositivo.
No teste externo, a MLP fica em 59,4%, contra 71,2% do Random Forest. Por isso os números do estudo são do Random Forest, e a versão pública é apresentada como demonstração.
Confirmar a letra só depois de 30 quadros
Evita que a frase se encha de letras erradas durante a transição de um sinal para outro.
Soletrar fica mais lento: cada letra exige segurar o sinal por um instante.
Resultado
- Um reconhecedor que roda em tempo real com uma webcam comum, sem GPU dedicada: 19,5 FPS de ponta a ponta.
- Uma avaliação em três níveis: 99,96% com vazamento, 97,0% com a divisão por grupos e 71,2% com imagens de outra fonte.
- Uma explicação para a queda: letras que seguem outra língua de sinais e pares que diferem por detalhes finos.
- Uma versão pública que qualquer pessoa pode testar no navegador.
Próximos passos citados no TCC: avaliação entre usuários diferentes, imagens de Libras com sinalizantes identificados e sinais dinâmicos com modelos temporais (LSTM ou Transformers).
Aprendizados
- Uma acurácia perto de 100% é sinal para investigar, não para comemorar.
- A forma de dividir treino e teste mudou o resultado mais do que trocar de modelo: 99,96%, 97,0% ou 71,2%, conforme a amostra de teste fica mais "nova".
- Generalizar exige dados variados: outras pessoas, iluminação, distância e ângulo. Esse é o principal trabalho futuro.